


Een agent koppelen aan Unity Catalog-functies, een SQL warehouse en een paar managed MCP-servers kost een middag. Hem bruikbaar houden tijdens een taak die uren duurt, is ander werk. Iets moet onthouden wat de agent al heeft gedaan, merken dat een job run is mislukt, en de draad vasthouden als het contextvenster volloopt.
Dat werk gebeurt in het systeem rond de agent. De agent zelf is een loop: een model dat tools, geheugen en feedback uit zijn omgeving gebruikt tot de taak klaar is. Wie het systeem rond die loop bouwt, is het verschil tussen een agent framework en een agent harness.
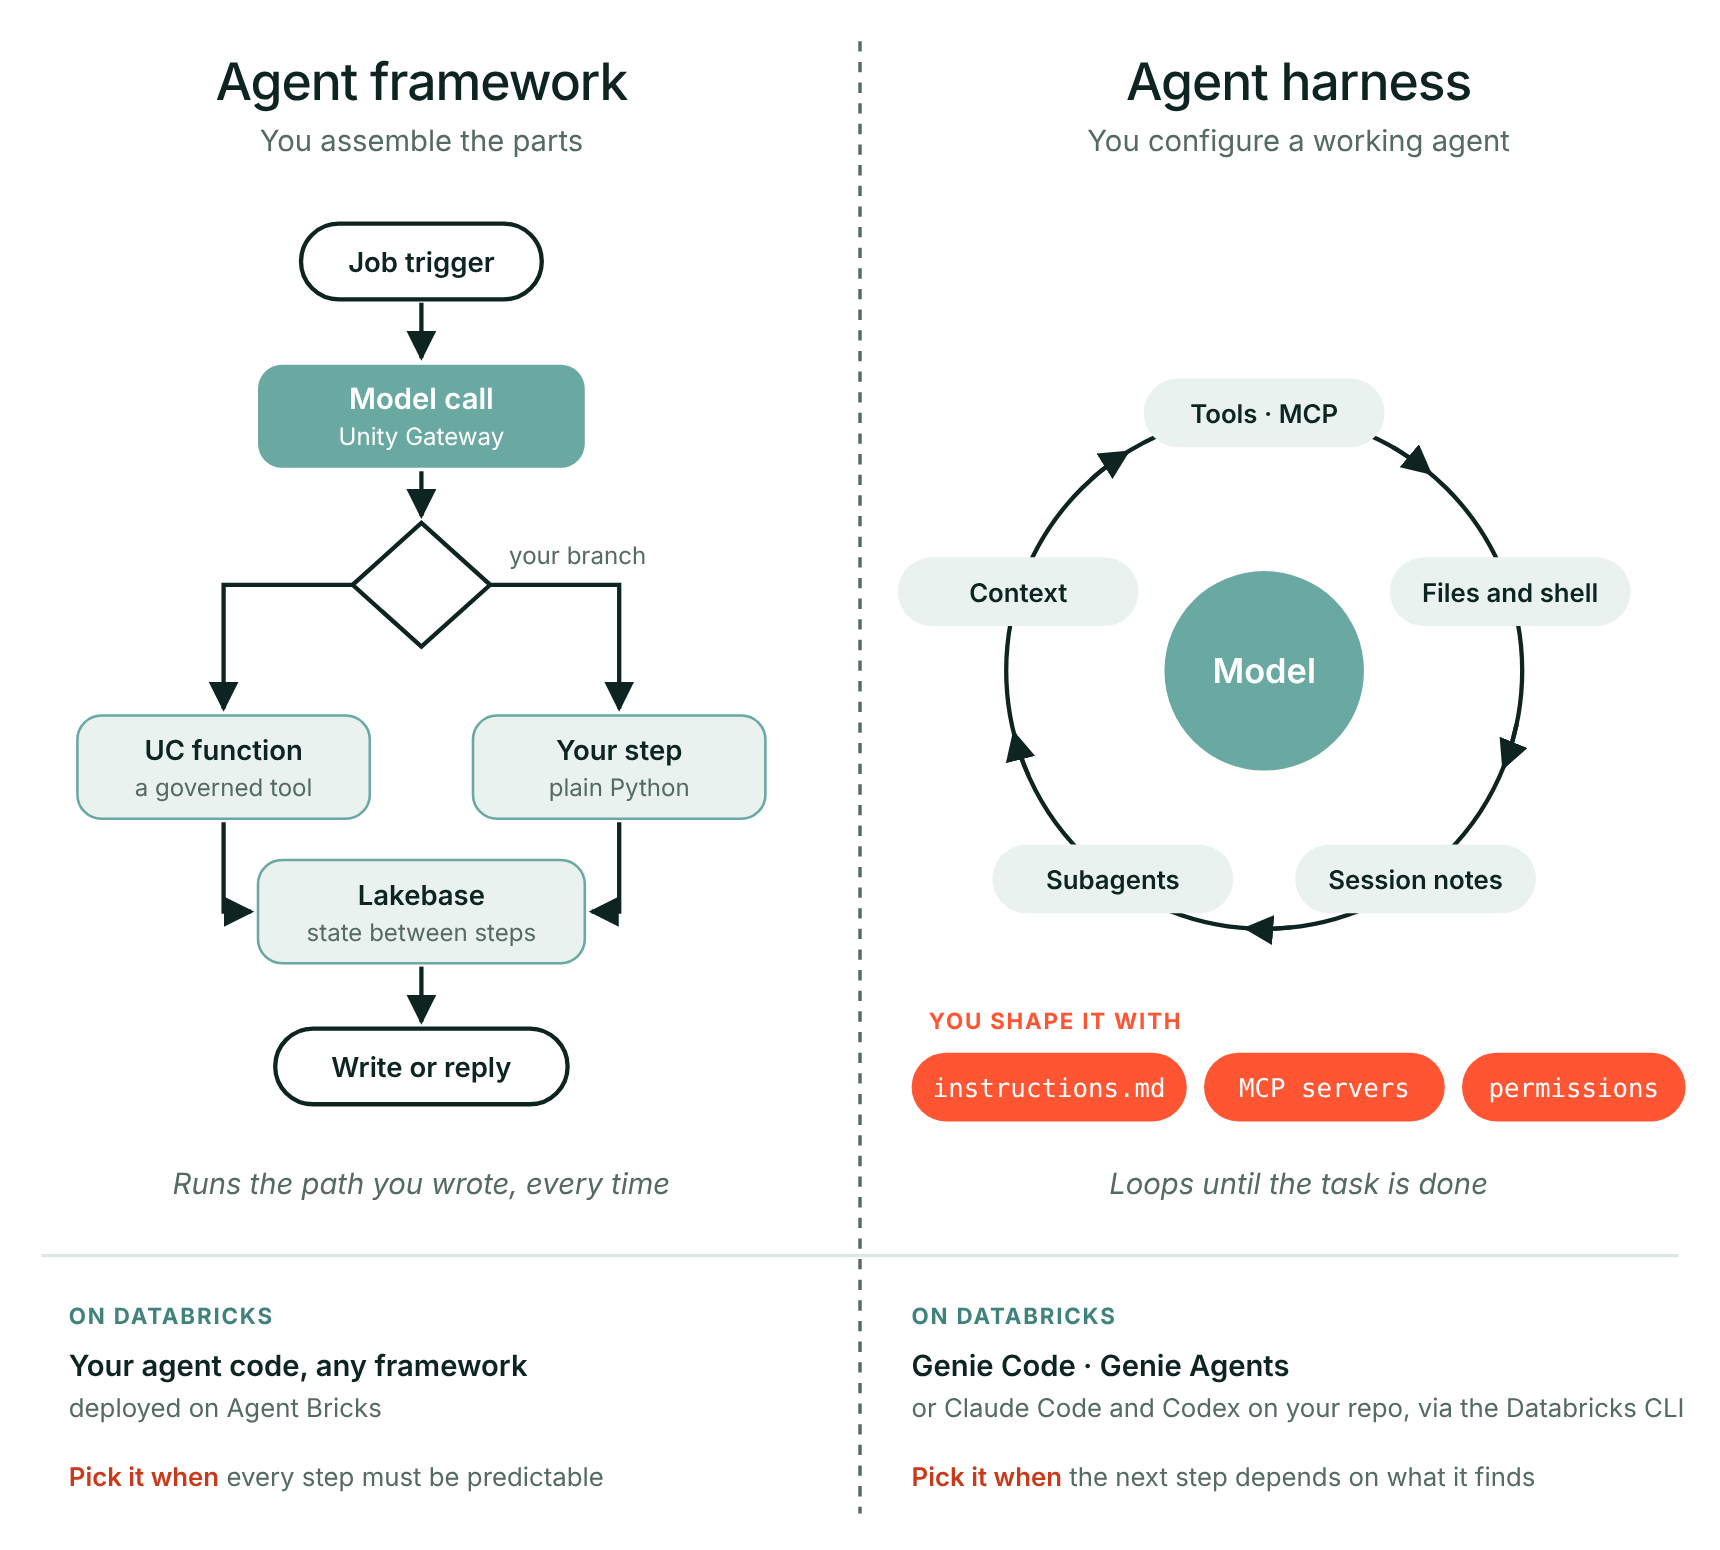
Met een framework krijg je de onderdelen, zoals modellen, tools en state, en bepaal je per stap welke kant de flow op gaat. Met een harness krijg je de loop met alles eromheen al ingericht, klaar om te configureren. Genie Code en Claude Code zijn voorbeelden. Je kunt je eigen harness bouwen op een framework, maar dan onderhoud je die ook.
De keuze is dus hoeveel van dat systeem je zelf wilt bouwen en draaiende houden. Dit stuk volgt één agent door allebei: gebouwd met een framework, daarna aangepast met een harness.
Twee manieren om aan een agent te komen
De framework-route. Op Databricks liggen alle onderdelen klaar, gebundeld door Agent Bricks: modellen via Unity Gateway, tools als Unity Catalog-functies en MCP-servers, geheugen in Lakebase, elke stap getraced in MLflow. Wat ze samenbindt, is code die je zelf schrijft, in een framework zoals LangGraph of OpenAI Agents SDK, gedeployed op Agent Bricks. Je krijgt volledige controle over het ontwerp, en al het werk dat daarbij hoort.
De harness-route. Een harness levert de loop samen met een omgeving om hem in te draaien: bestanden lezen, commando's uitvoeren, context inkorten als die volloopt, notities bijhouden over de voortgang tussen sessies, werk doorgeven aan subagents. Databricks levert er zelf een: Genie Agents voor low-code agents op je data, en Genie Code voor werken in code, ingebouwd in notebooks, de SQL-editor en Lakeflow. Claude Code en Codex zijn de andere gangbare keuze voor code. Die werken op je bundle-repo en bereiken de workspace via de Databricks CLI en de managed MCP-servers. Je bouwt de loop niet. Je configureert hem: een markdownbestand in de repo met je targets en conventies, de MCP-servers die hij mag aanroepen, en de permissieregels die zeggen wat hij mag uitvoeren.
Met een framework zit je zelf aan het stuur
Een agent framework geeft je de bouwstenen voor een agent: modellen, tools, state en de orkestratie daartussen. Met die bouwstenen bepaal je stap voor stap hoe je agent zich gedraagt. Die controle is de belangrijkste reden om er een te kiezen.
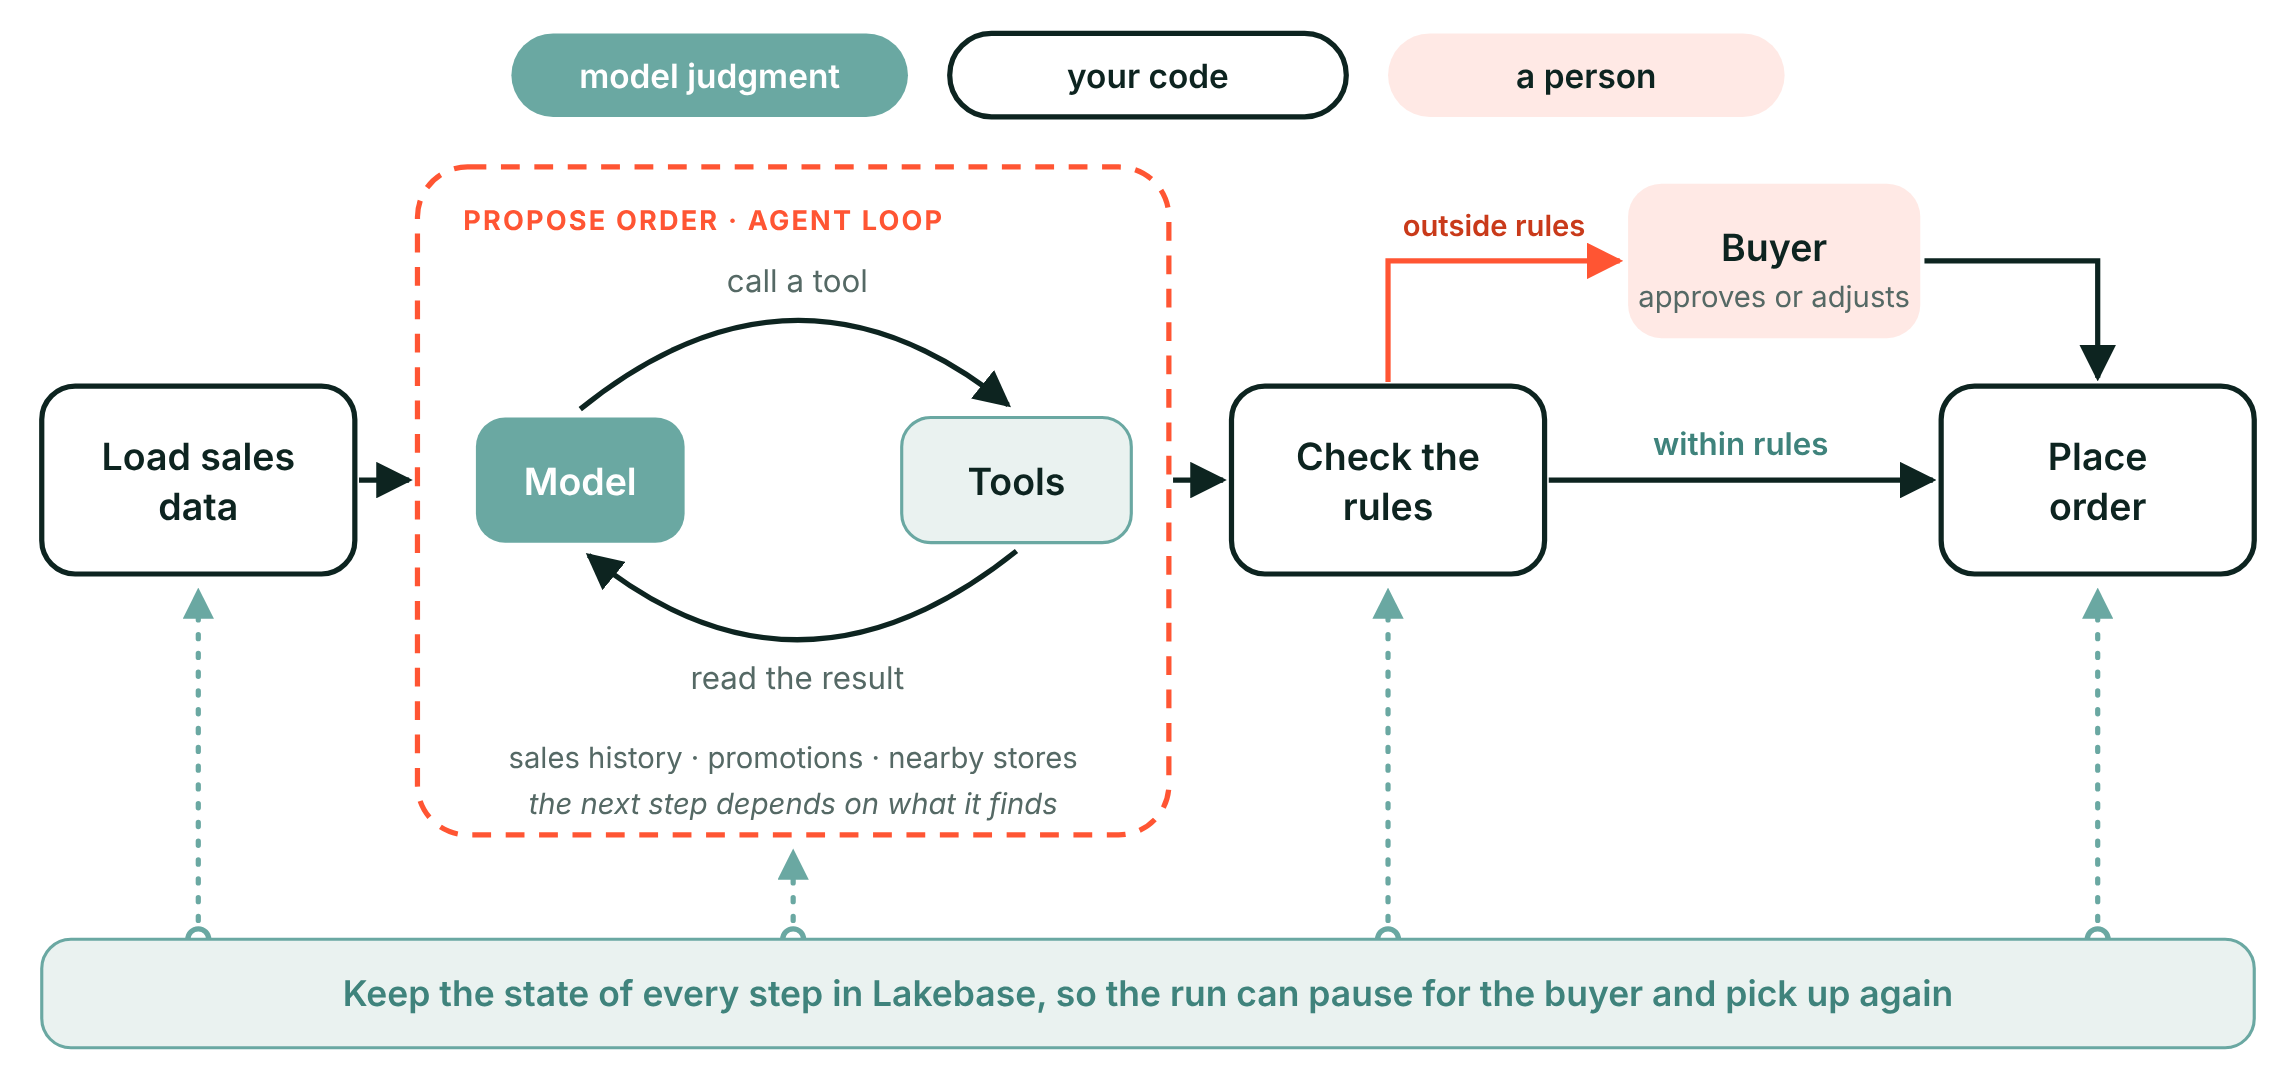
Een voorbeeld. Neem een bevoorradingsagent voor een retailketen, gebouwd met een agent framework op Agent Bricks. Elke nacht heeft hij voor elke winkel vier taken:
- Kijk naar recente verkopen, het seizoen en komende promoties, en stel per product een bestelling voor.
- Toets die bestelling aan de regels: het budget van de winkel, de minimale bestelhoeveelheid van de leverancier, de afgesproken leverdagen.
- Stuur alles wat daarna nog buiten die regels valt naar een inkoper.
- Plaats de bestelling bij de leverancier.
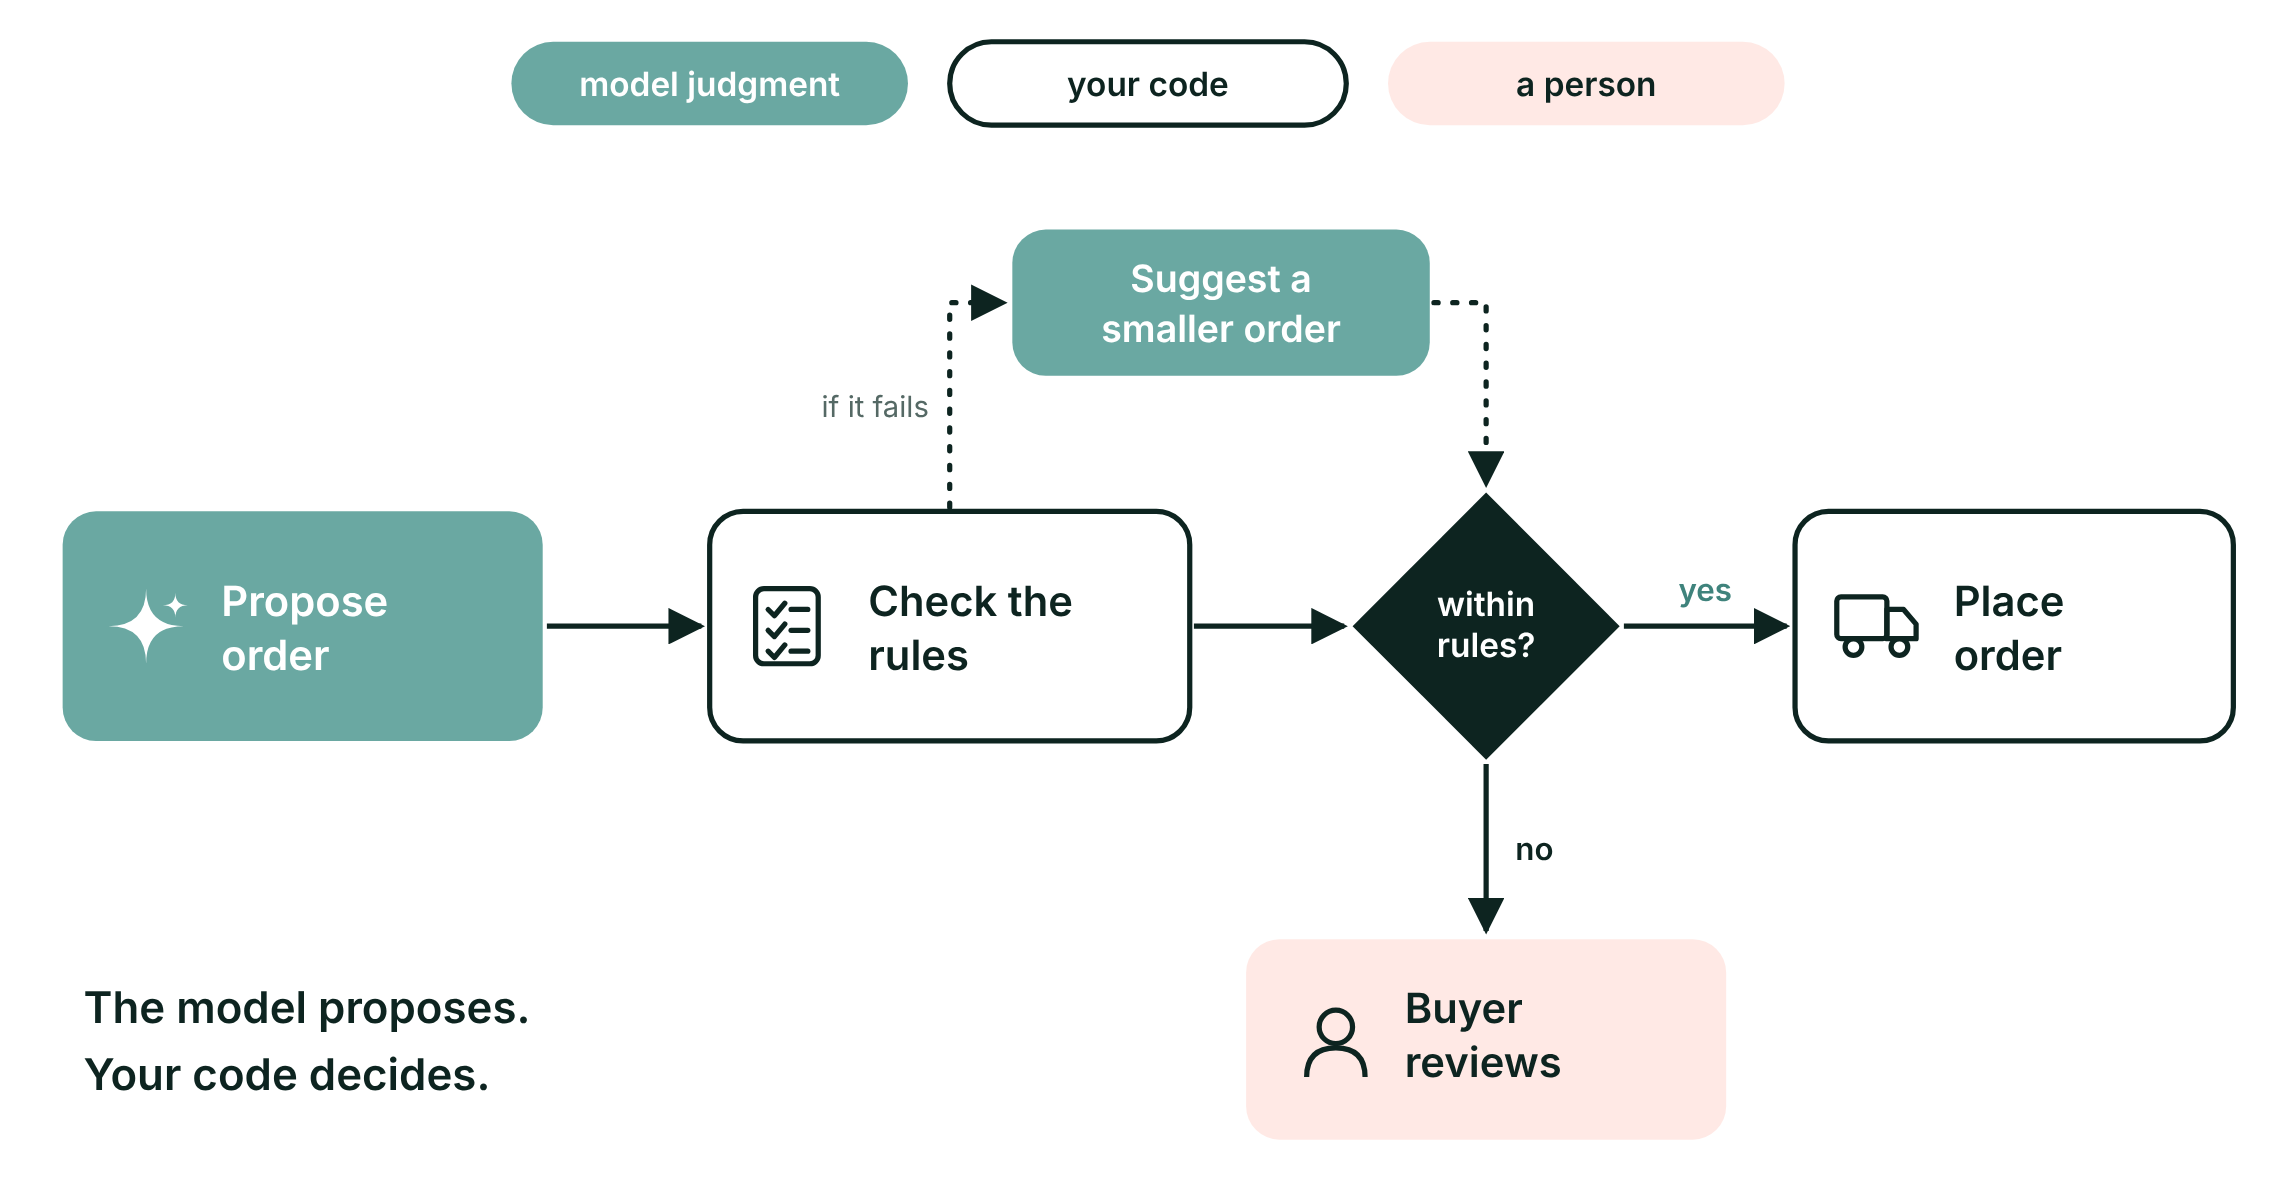
Stap 1 vraagt om oordeel: de vraag beweegt mee met het weer, feestdagen en promoties, dus het model doet die stap. Stap 2 tot en met 4 mogen nooit van het oordeel van het model afhangen, want een verkeerde bestelling kost meteen geld. Met een framework bouw je die grens in de agent zelf. Het model stelt een bestelling voor. Een stap in je eigen code toetst die aan budget en leveringsvoorwaarden, met de tabellen die al in je lakehouse staan. Pas als de toets slaagt, krijgt de agent de tool die de bestelling plaatst. Slaagt hij niet, dan beslist een inkoper.
Niet alleen vaste flows. Een framework dwingt je niet om elke stap vooraf uit te tekenen. De stap "bestelling voorstellen" uit het voorbeeld is eigenlijk een open agent loop: het model bekijkt de verkoophistorie, kijkt naar de promotiekalender, vergelijkt winkels in de buurt, en bepaalt op basis van wat het vindt waar het daarna naar kijkt. Rond die loop blijft het pad van jou: het laden van de data ervoor; de regeltoets, de inkoper en de bestelling erna. Je kunt de state van elke stap in Lakebase bewaren, zodat een run kan pauzeren voor de inkoper en verdergaat waar hij gebleven was.
Dan blijft er voor elke agent die je bouwt één vraag over: welke onderdelen wil je zelf bepalen, en welke krijg je liever kant-en-klaar?
Lagen, geen concurrenten
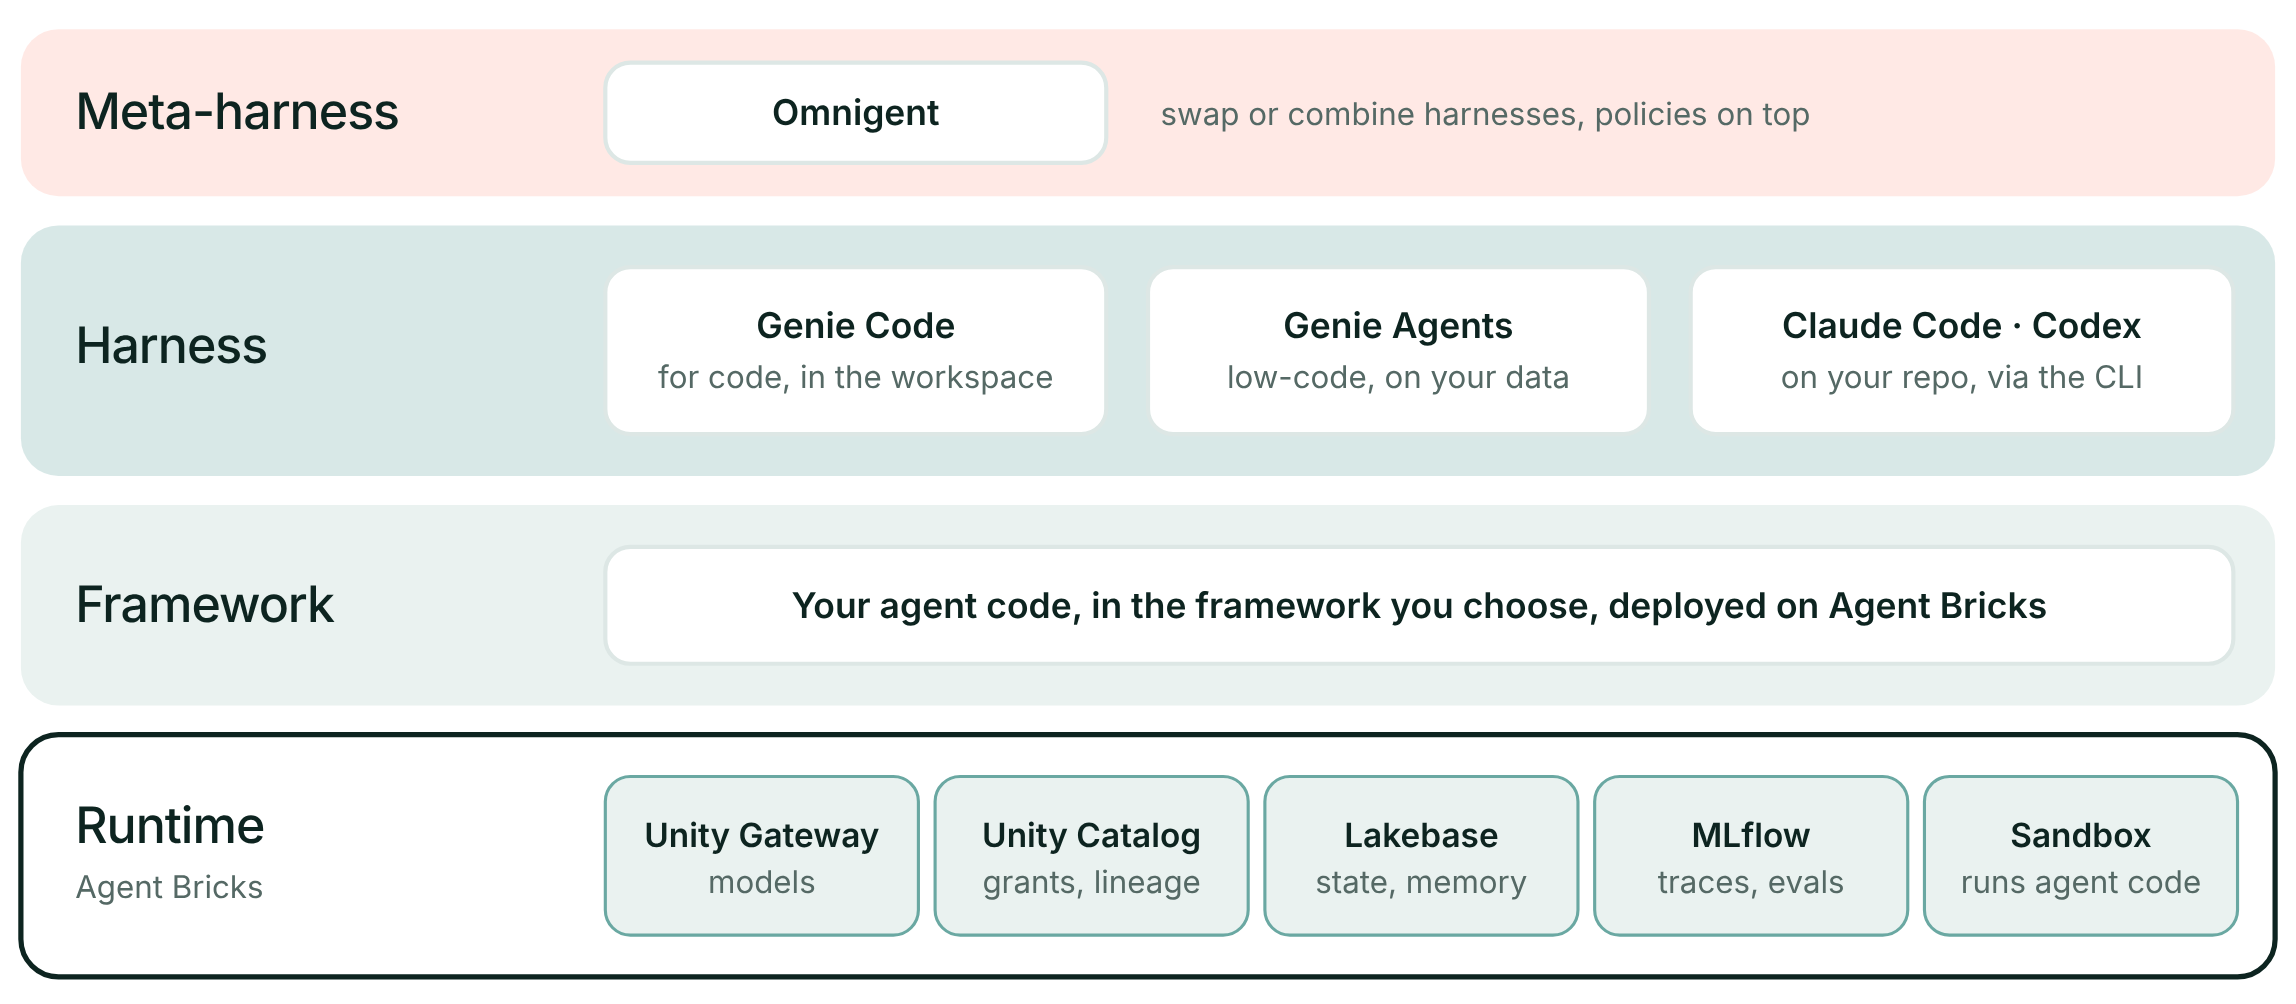
Framework en harness zijn geen concurrerende producten. Het zijn lagen van één stack: je kiest per taak, en de keuzes stapelen. Op Databricks heeft elke laag een concrete invulling.
- Runtime: Agent Bricks, met Unity Gateway voor modellen, Unity Catalog voor grants en lineage, Lakebase voor state en MLflow voor traces en evaluatie.
- Framework: je eigen agentcode, in het framework dat je kiest, gedeployed op Agent Bricks.
- Harness: Genie Code en Genie Agents in de workspace, of Claude Code en Codex op je repo, via de Databricks CLI en managed MCP-servers.
- Meta-harness: Omnigent, de open-source laag van Databricks die boven meerdere harnesses zit, je ze laat wisselen of combineren en policies buiten het model afdwingt.
Wat er in een coding harness zit
Open een coding harness en je vindt zes onderdelen rond de loop. Ze bestaan allemaal om één reden: het contextvenster gevuld houden met wat het model nodig heeft, en niets anders.
- Repo-context. Laadt je instructies en de opbouw van de repo vóór je eerste woord.
- Prompt caching. Houdt een stabiel begin aan, zodat herhaalde beurten goedkoop blijven.
- Toolgebruik. Voert commando's uit en roept tools aan, binnen de permissieregels die je instelt.
- Contextreductie. Knipt tooloutput in voordat die het venster overspoelt.
- Gestructureerd sessiegeheugen. Schrijft notities die de sessie overleven.
- Subagents. Geeft afgebakende zijtaken aan een verse context.
Coding harnesses zijn de harness-route die de meeste teams al gebruiken, en ze werken op agents die via de framework-route zijn gebouwd, zoals deze.
De rest van dit stuk volgt één wijziging aan de bevoorradingsagent, gemaakt met een harness: wie bepaalt wanneer hij klaar is, waar zijn state staat, en hoe je hem test.
Een afgeronde loop is geen afgeronde klus
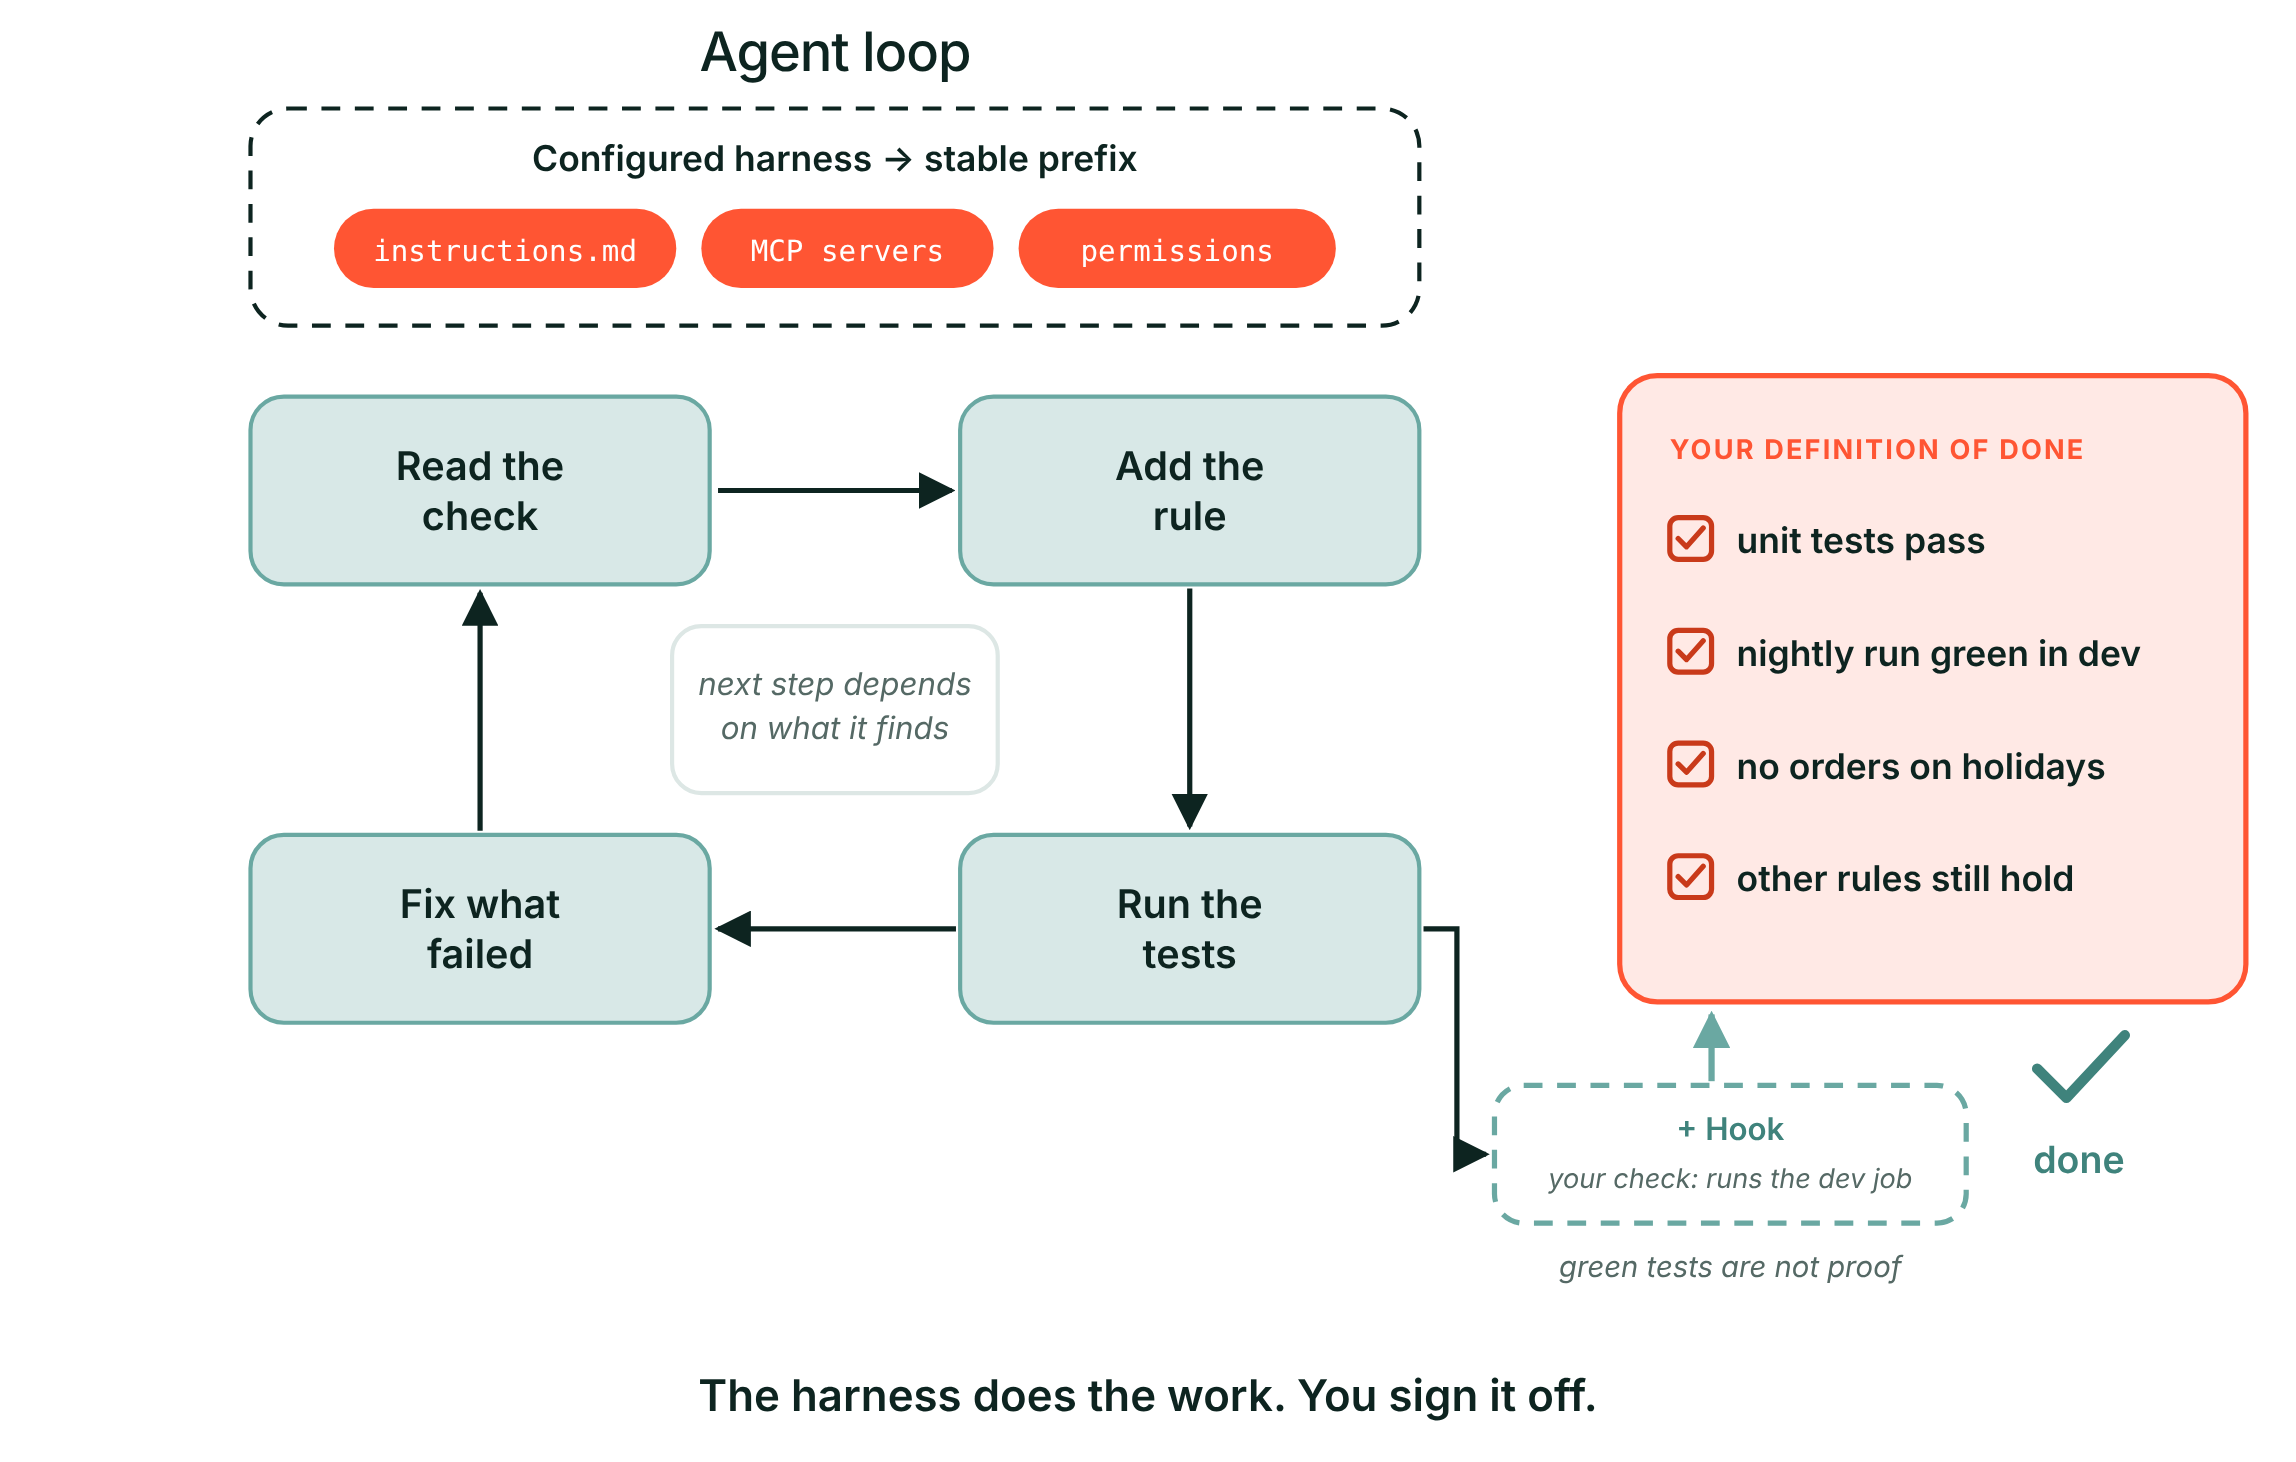
Hier komen repo-context en toolgebruik in beeld. Voor een codeertaak verandert een harness waar je begint. Je bouwt de onderdelen die bestanden lezen, ze bewerken en commando's uitvoeren niet zelf. Je configureert een harness die ze al heeft: een instructiebestand in je repo, de tools die hij mag gebruiken, en de grenzen van wat hij mag aanraken.
Het model werkt dan zoals een engineer zou werken. Het leest de code, maakt een wijziging, draait de tests, en kiest de volgende stap op basis van wat het vindt.
Wat het niet voor je kan bepalen, is wanneer het werk klaar is. Een loop die eindigt in groene tests bewijst alleen dat de loop heeft gedraaid.
Neem het agent framework van hierboven. De inkopers willen een nieuwe regel: geen bestellingen op feestdagen. Je vraagt Genie Code, of Claude Code op de repo van de agent, om die aan de toetsstap toe te voegen. De harness leest de toets, voegt de regel toe, schrijft tests en loopt door tot ze slagen. Dan meldt hij dat hij klaar is. Maar voor deze wijziging betekent klaar vier dingen: de unittests slagen, een nachtelijke run in dev komt door, er landen geen bestellingen op een feestdag, en de andere regels werken nog. Zet die lijst in het instructiebestand, of beter, in een hook die de harness niet kan overslaan.
Lange taken: houd de state buiten het gesprek
Hier werkt contextreductie tegen je, en moet sessiegeheugen dat goedmaken. Stel dat de wijziging twee dagen kost. Op dag één voegt de harness de regel toe, deployt naar dev en start een nachtelijke run. De run faalt op één winkel. Dan loopt het contextvenster vol, en vat de harness het samen: "feestdagregel toegevoegd, tests slagen".
Het doel overleeft. Wat dag twee nodig heeft, is weg: dat de dev-run faalde, op welke winkel, en dat de dev-orderstabel nu een testbatch bevat. Dus dag twee begint vol vertrouwen, en deployt blind opnieuw.
De oplossing is de state van het werk bewaren waar de volgende sessie hem kan lezen, buiten het model. Elke plek beantwoordt een andere vraag, en twee daarvan houdt Databricks voor je bij: de run-historie en de tabelhistorie.
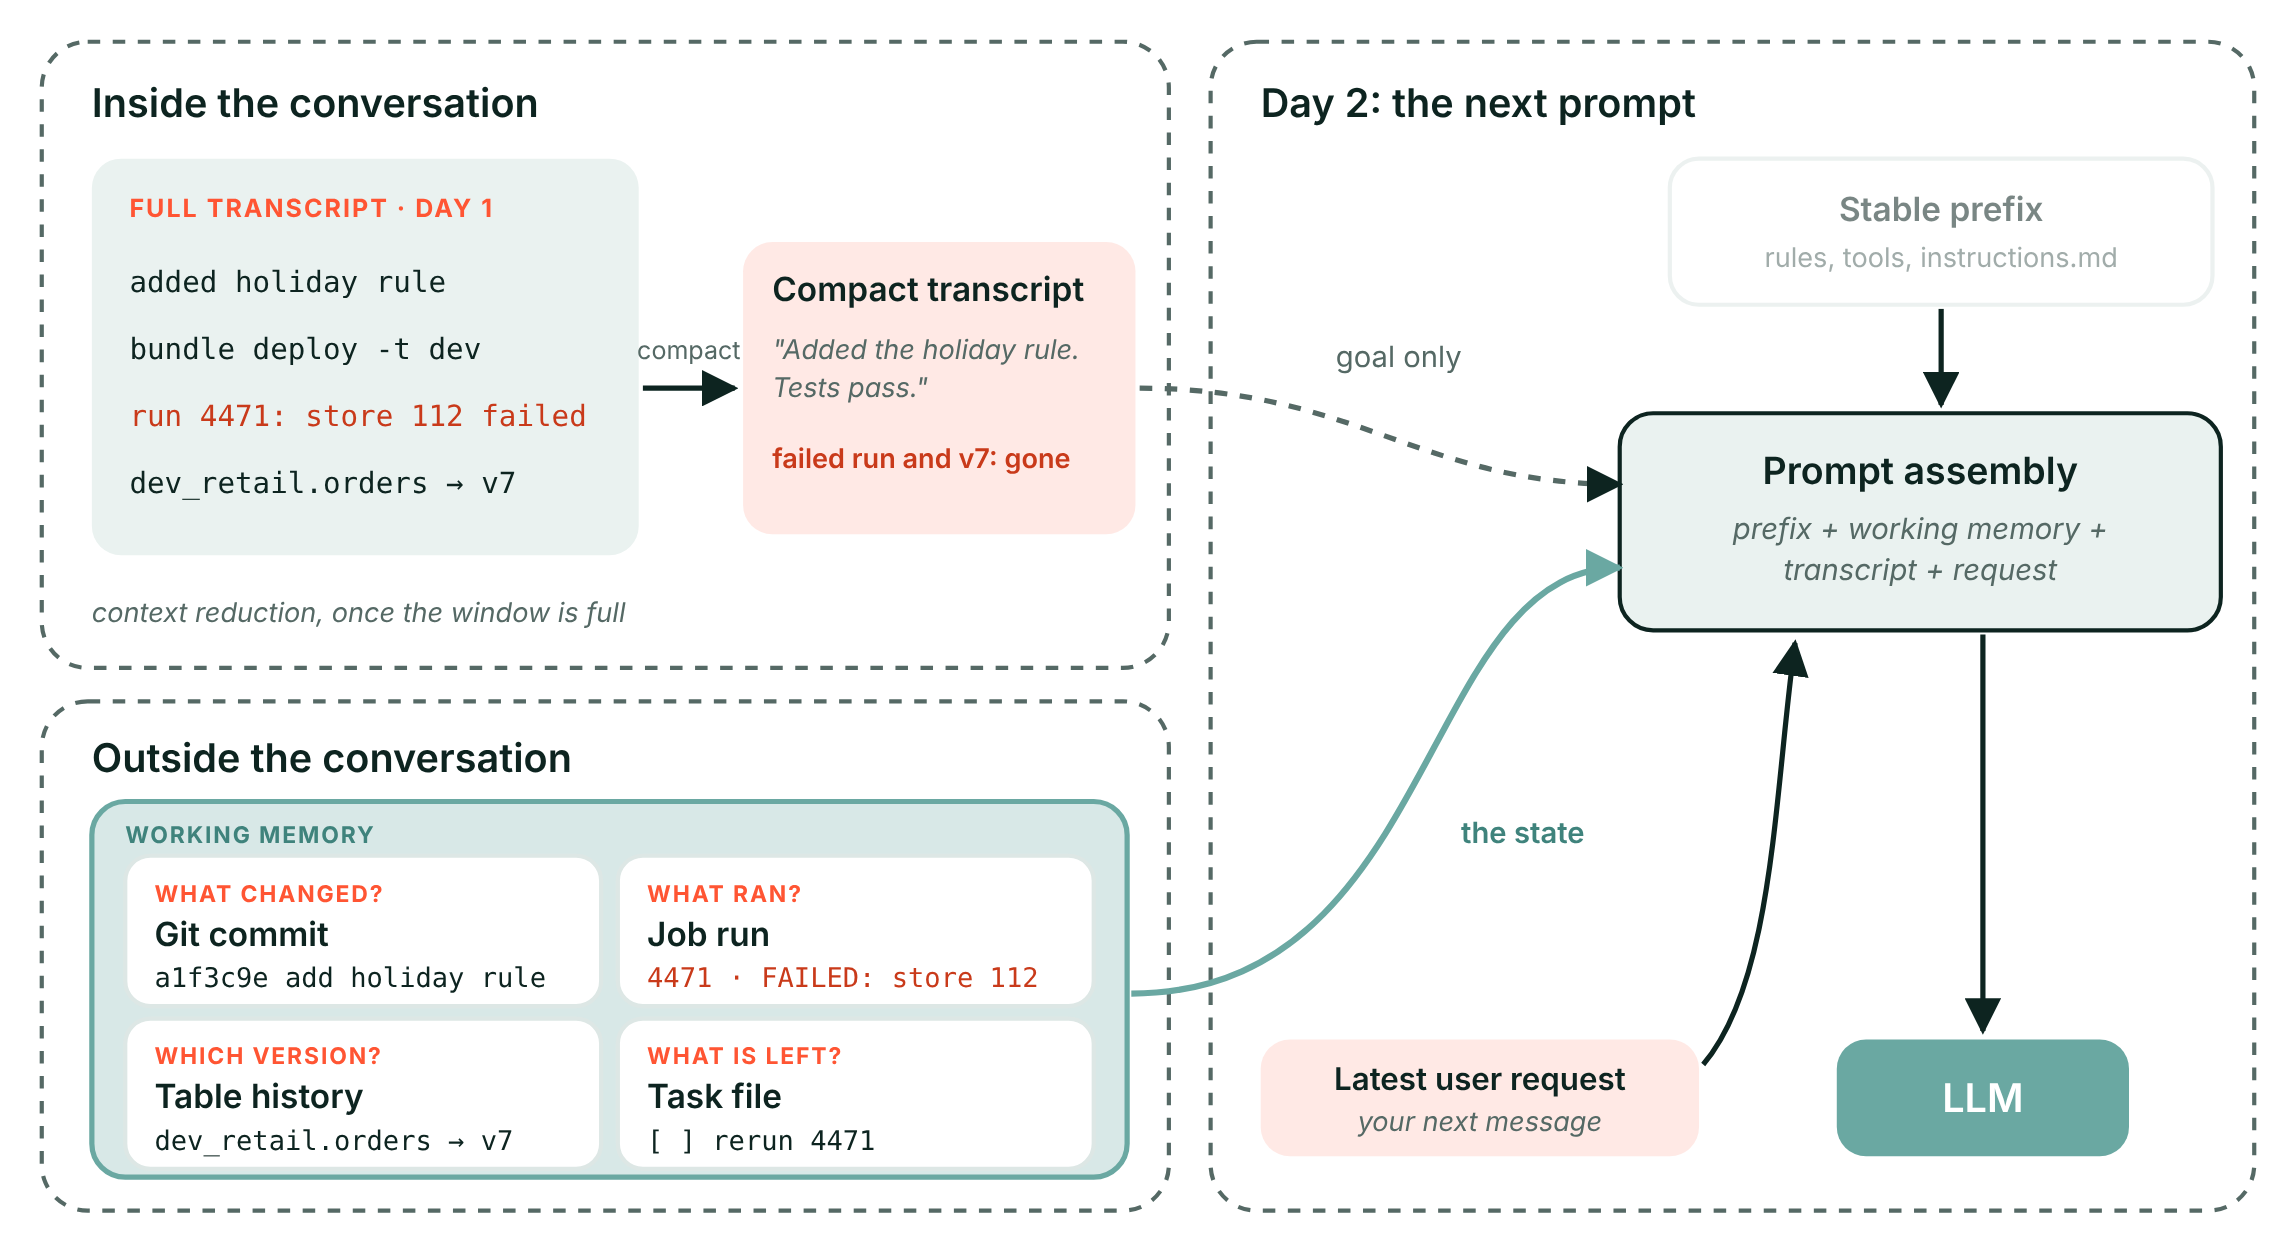
Laat de harness dus voordat een sessie eindigt zijn werk committen, het run-ID noteren en het takenbestand bijwerken. Dan begint dag twee bij feiten, niet bij een samenvatting.
Test wat er gebeurt na een fout
Dit test het sessiegeheugen, en hoe ver je toolregels doorwerken in subagents. Een vlekkeloze demo zegt weinig. Een onderbroken run laat zien hoe het systeem rond het model zich gedraagt.
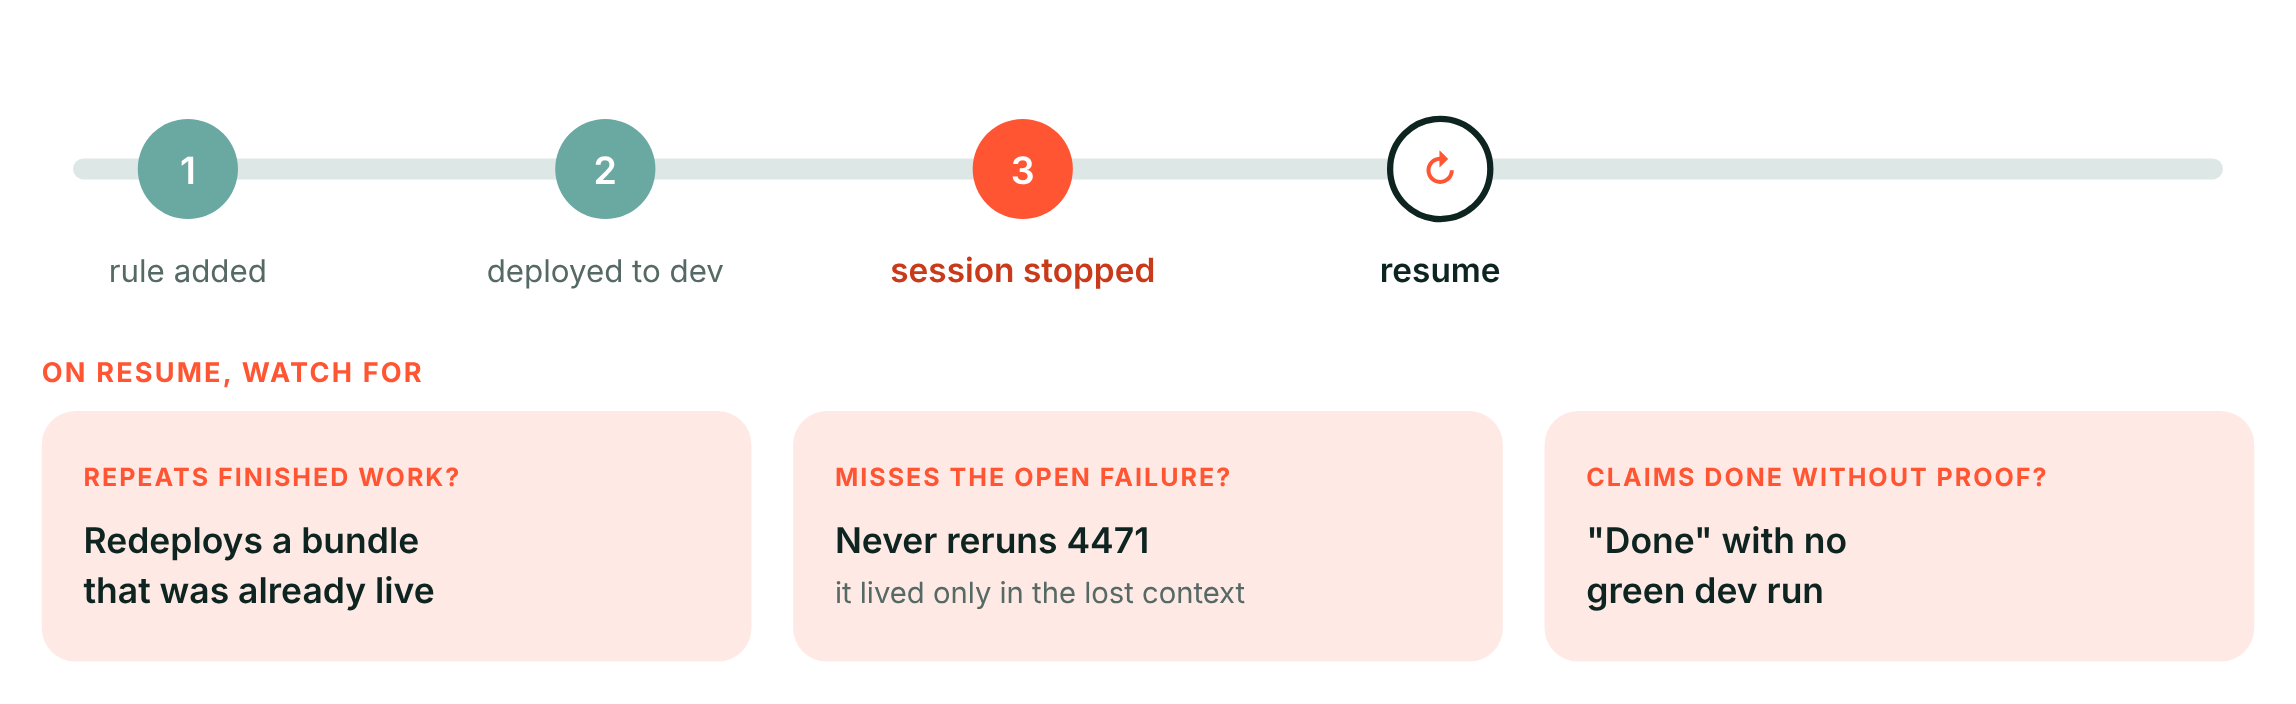
Geef de harness de feestdagwijziging. Laat hem de regel toevoegen en naar dev deployen, en stop de sessie voordat hij iets controleert. Hervat hem en let op drie fouten:
- Hij doet afgerond werk opnieuw. Hij deployt een bundle die al live stond in dev.
- Hij mist de openstaande fout. De mislukte dev-run stond alleen in de verloren context, dus hij draait hem nooit opnieuw.
- Hij meldt klaar zonder bewijs. Hij rapporteert succes zonder groene dev-run erachter.
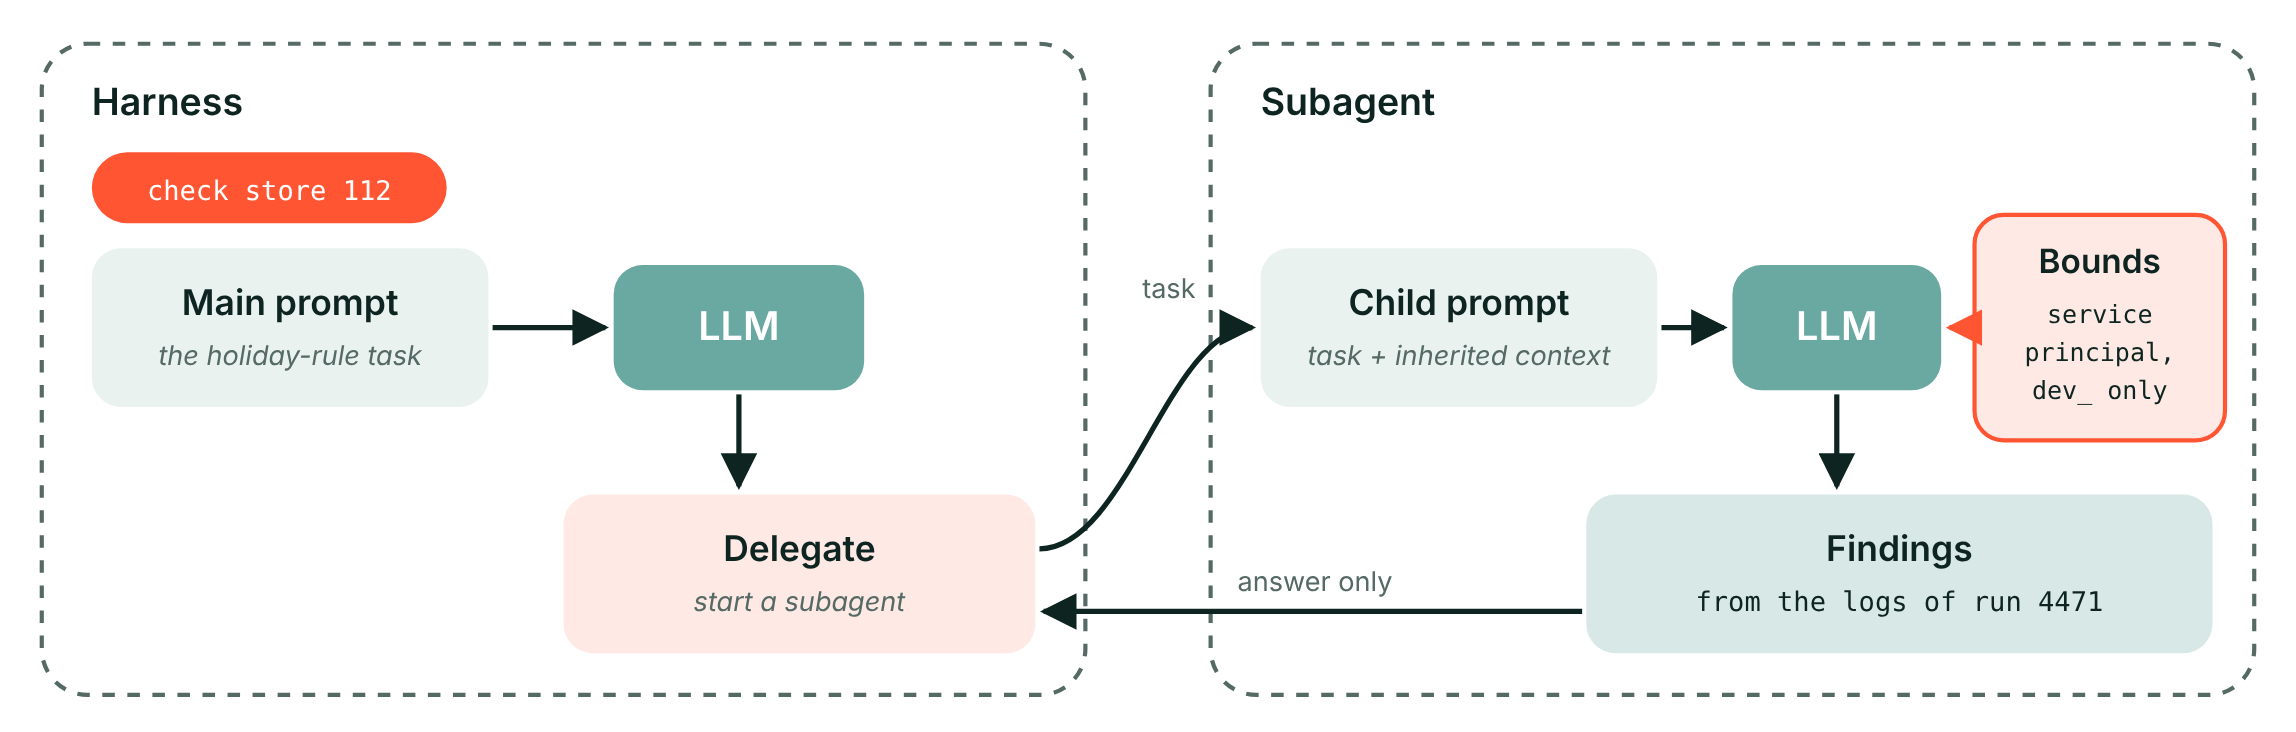
Controleer dan het delegeren. Stel dat de hervatte harness "controleer winkel 112" doorgeeft aan een subagent. Speelt die subagent volgens dezelfde regels? Op Databricks ligt het antwoord in Unity Catalog: draai de harness als service principal met grants op alleen dev_-catalogs, en elke subagent erft die grens, wat zijn prompt ook zegt. Hij leest de logs en stuurt alleen zijn antwoord terug.
Kort samengevat
Dit stuk keek naar twee manieren om een agent op Databricks te krijgen, en naar wat een harness overeind houdt.
- Framework of harness. Een framework geeft je de onderdelen en jij tekent het pad. Een harness geeft je een werkende loop die jij configureert.
- Met een framework bepaal jij waar het model stopt. Het model stelt voor, jouw code beslist, en een open agent loop kan nog steeds binnen een pad zitten dat jij bepaalt, zoals bij de bevoorradingsagent op Agent Bricks.
- Lagen, geen concurrenten. Frameworks en harnesses werken op dezelfde Databricks-stack, van Unity Gateway en Unity Catalog tot Lakebase en MLflow, en je kiest per taak. In een coding harness houden zes onderdelen het contextvenster gevuld met alleen wat het model nodig heeft.
- Een harness houdt stand door wat je eromheen bouwt. Je eigen definitie van klaar, state buiten het gesprek, en een test met een onderbroken run, met subagents binnen jouw grenzen.
Bouw je agents op Databricks en twijfel je welke route past? Neem contact op met Frits via LinkedIn.